
Rilevamento delle negazioni da referti clinici tramite AI
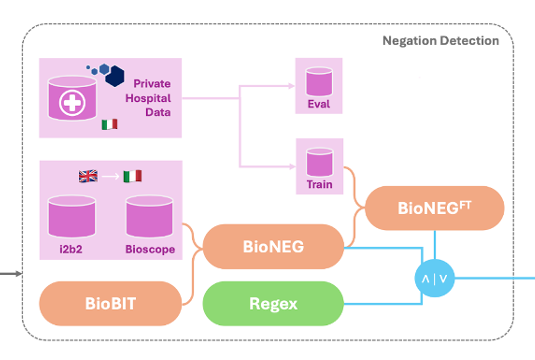
Il rilevamento delle negazioni è un passaggio fondamentale nell’estrazione di informazioni cliniche da testi non strutturati, come referti e note mediche.
Distinguere tra “presenza/assenza di infezione” può cambiare completamente il significato clinico di un documento e influire sulla qualità dell’integrazione dei dati sanitari.
Gli approcci tradizionali basati su espressioni regolari (REGEX), sebbene efficaci, richiedono un notevole lavoro manuale: la definizione di regole specifiche, l’annotazione di grandi quantità di dati e un feedback iterativo da parte dei clinici per aggiornare e mantenere le regole al passo con il linguaggio medico reale.
Un modello che usa trasformatori pre-addestrati offre un’alternativa a basso sforzo, riducendo significativamente la necessità di input clinici con elevata accuratezza.
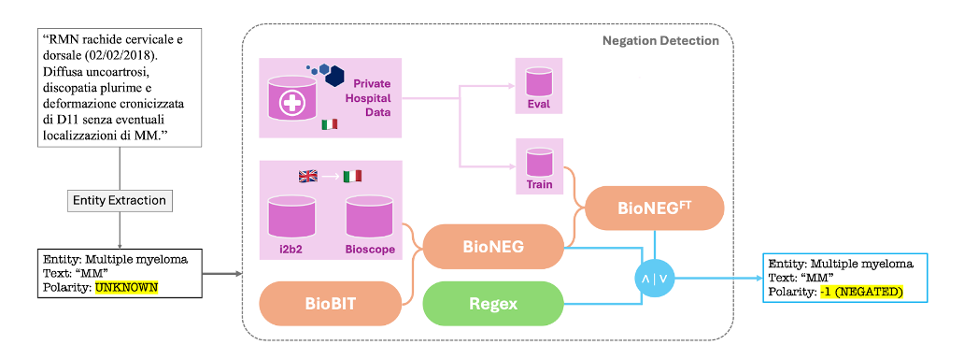
Il modello sviluppato si basa su BioBIT (un modello linguistico biomedicale italiano), addestrato su circa 38000 esempi da set di dati pubblici tradotti in italiano (Bioscope e i2b2 2010) in modo da perfezionare BioBIT in BioNEG (modello specializzato nel rilevamento delle negazioni).
BioNEG è stato poi validato su circa 500 frasi estratte da referti clinici di 3 ospedali italiani (Policlinico di Milano, Papa Giovanni XXIII di Bergamo e ASST Ovest Milanese di Legnano), che sono state verificate in modo indipendente da due annotatori per determinare se il concetto fosse presente o assente.
Il 40% di questo dataset annotato è stato usato per un ulteriore perfezionamento del modello, chiamato BioNEGft.
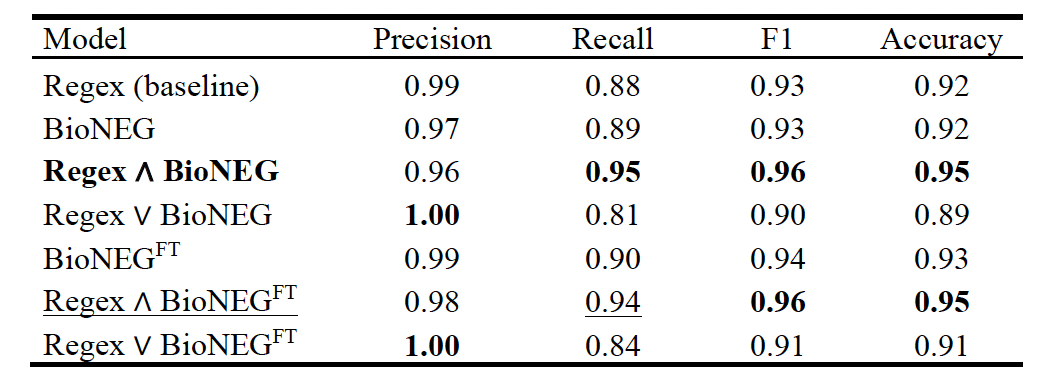
I modelli Regex e BioNEG hanno ottenuto prestazioni comparabili (con un’accuratezza del 92% e un punteggio F1 di 0,93), ma con un enorme vantaggio in termini di riduzione del lavoro manuale.
BioNEGft ha ottenuto un incremento minimo dello score F1 (0,94) che potrebbe non giustificare i benefici di un’ulteriore messa a punto sui dati locali annotati.
Combinando i due approcci (Regex e BioNEG) in modalità AND, si ottengono le migliori performance complessive (F1 0,96 e accuratezza 0,95), suggerendo un uso complementare come sistema di doppio controllo.
Lo studio dimostra che un modello come BioNEG, progettato per rilevare asserzioni di negazione in testi clinici italiani, può eguagliare le prestazioni dei tradizionali approcci basati su espressioni regolari, con una minore necessità di intervento umano e maggiore adattabilità.
Riferimenti:
- Buonocore TM, Mognaschi S, Beretta L, Venturelli S, Fattizzo B, Bruschi E, Cassani C, Benatti S, Marinoni S, Vettoretti S, Gabetta M. From Regex to Encoders: Low-Effort Negation Detection for Healthcare Data Integration in Italian Hospitals. pp 62–66 – Artificial Intelligence in Medicine (AIME 2025). (link)


